太长不读版:在编程任务中,不论何时谷时 DS 仍然更具性价比。GLM 半价期间适合做 DS 峰时的替代,原价之后则只适合作为 DSPro 在峰时的平替。
凌晨我看到 GLM 5.3 Flash 发布,我瘫坐在核弹上,仿佛看到椅子爆炸。在 DeepSeek 涨价之后终于迎来一个新的模型把涨价后的 DeepSeek 推入斩杀线,国模迎来了新的性价比一哥,性能强还便宜,好像回到了 DeepSaeek 宣布永久降价时的黄金时代。
但是朋友们,不要被官网价格诈骗了:
| 元/M Token | DSV4Flash 谷时 | GLM 5.3 Flash 半价 | DSV4Flash 峰时 | GLM 5.3 Flash 原价 |
|---|
| 输入 I | 1.50 | 0.40 | 3.00 | 0.80 |
| 缓存 C | 0.05 | 0.115 | 0.10 | 0.23 |
| 输出 O | 4.50 | 1.40 | 9.00 | 2.80 |
非常显然,GLM 5.3 Flash 能否斩杀 DeepSeek V4 Flash 还得看缓存命中怎么样。
我们先来算笔账:
为了方便计算,我们需要定义两个变量:
r=输入Token数量输出Token数量
h=缓存命中率
其中 0%≤h≤100%
不难得出,总成本公式为:
Cost=(1−h)I+hC+rO
代入上述数据:(下标中 D 和 G 表示 DeepSeek 与 GLM,L 标识谷时/半价,H 表示峰时原价)
CostDL=1.5(1−h)+0.05h+4.5r
CostGL=0.4(1−h)+0.115h+1.4r
化简后得
CostDL=2090r−29h+30
CostGL=200280r−57h+80
由于两个都恰好是半价,所以算峰价和原价只要乘以 2 就好:
CostDH=1090r−29h+30
CostGH=100280r−57h+80
半价 GLM vs 谷时 DS#
现在我们开始研究,对几种情况的临界点分别建立方程,先看第一种:半价 GLM vs 谷时 DS
令
CostDL=CostGL即
2090r−29h+30=200280r−57h+80解得
h=233620r+220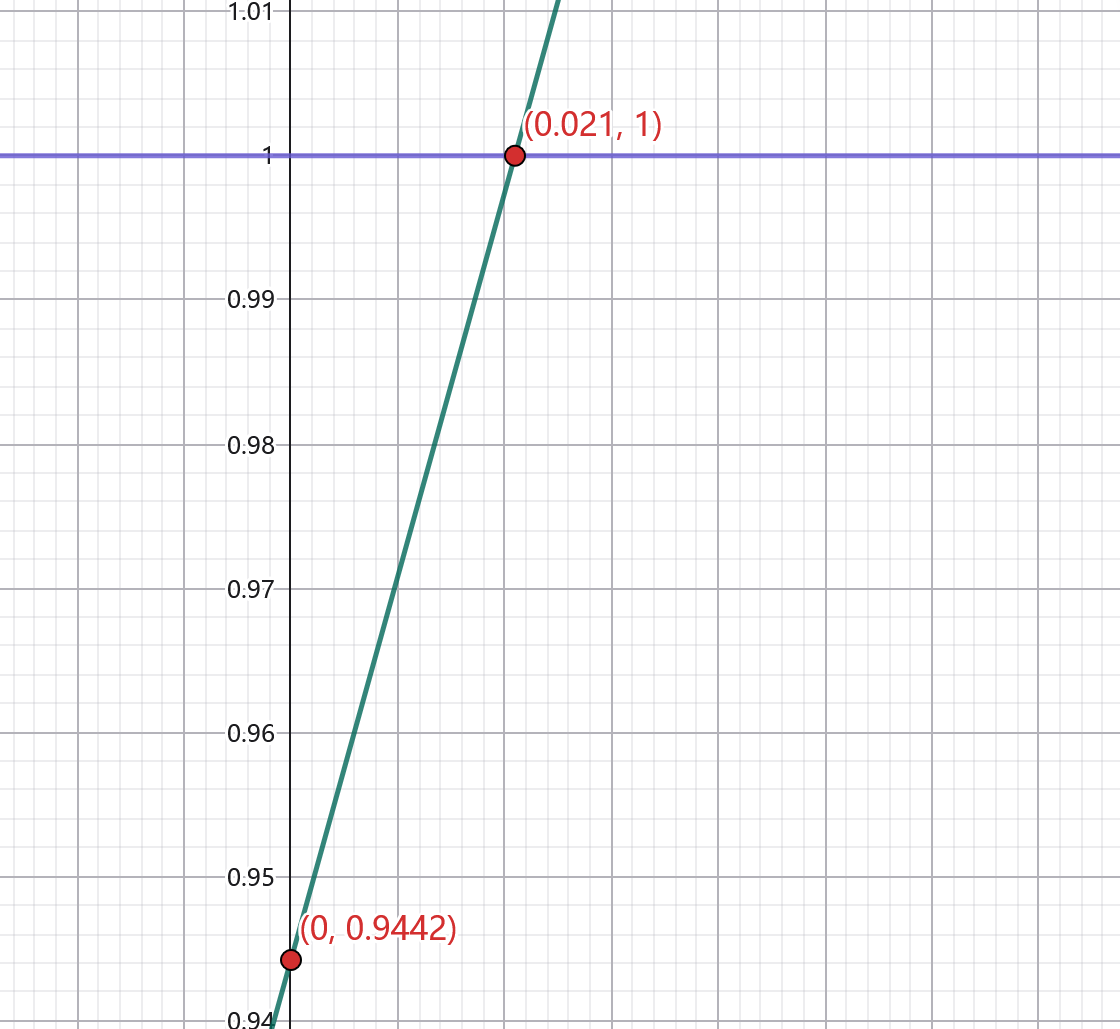
放在平面直角坐标系里长这样,其中紫色的线代表缓存命中神奇地达到了 100% 的情况,本图包括下文图中的点的坐标均四舍五入后保留 4 位小数,以便读者自行换算为百分数。
这意味着,当 r>0.021 时,GLM 总是比 DS 便宜;然而当 r→0 时,若 h>94.42% 则仍然是 DS 比 GLM 便宜。
取一个我真实开发场景的例子
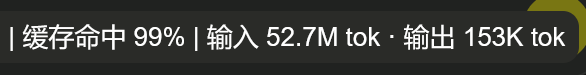 DSH 一次任务的统计数据
那么代入计算:
r=52700000153000≈0.003符合 r→0 的情况,且 h=0.99,那么显然在我个人的应用场景下,选择梁文谷 DSFlash 性价比更高。
半价 GLM vs 峰时 DS#
可能也许你会想到他也许可以去作为一个 DS 在峰时的平替,那我们来算一算:
同理,令
CostDH=CostGL即
1090r−29h+30=200280r−57h+80解得
h=5231520r+520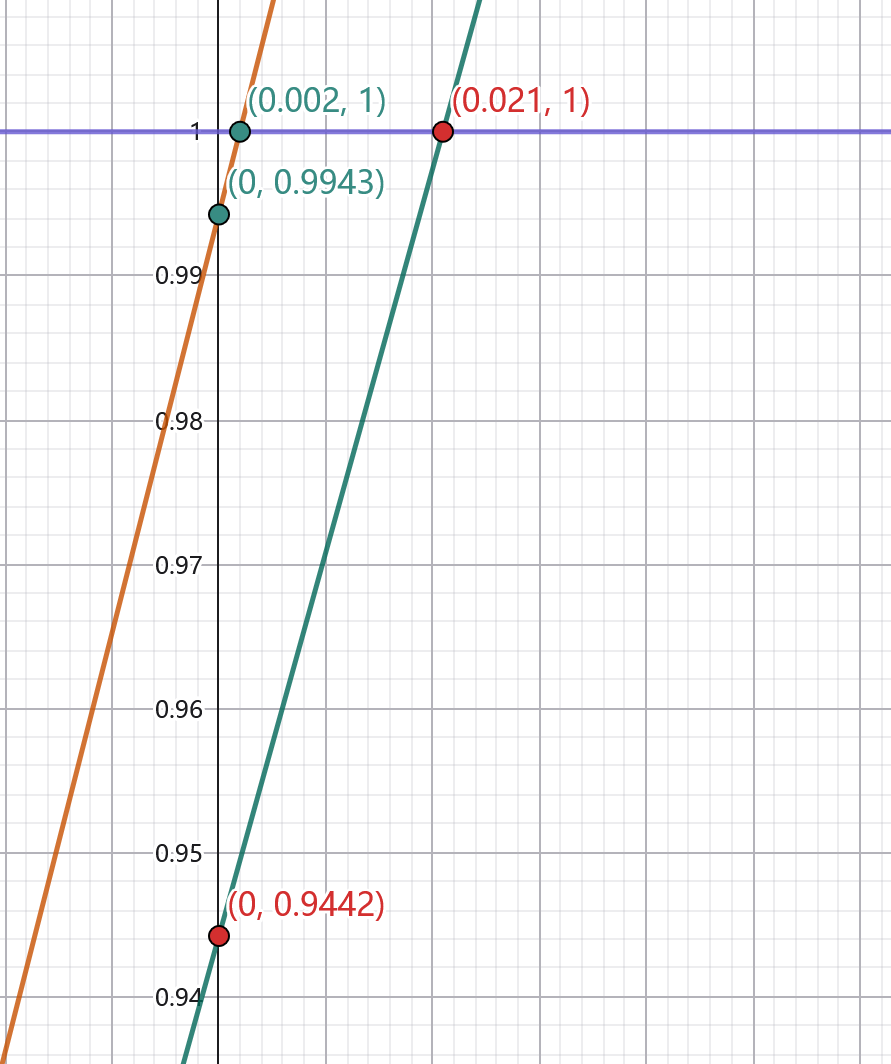
不难发现的是,函数图像(黄线绿点)明显左移了,这意味着在这两周 GLM 半价活动时,还是能与 DS 打一打的。在梁文峰时,仅当 r<0.002 且 h>99.43% 是 DS 才会是更好的选择。所以在峰时,GLM 比 DS 更便宜,性能也更强。
原价 GLM vs 谷时 DS#
可能你更加好奇,半价又会结束以后呢?
来吧,管他这那的,我们都有数据了,算就完了。过程同上,依然是令相等然后求解关于 h 的方程。此处过程略过,解得:
h=4485r+35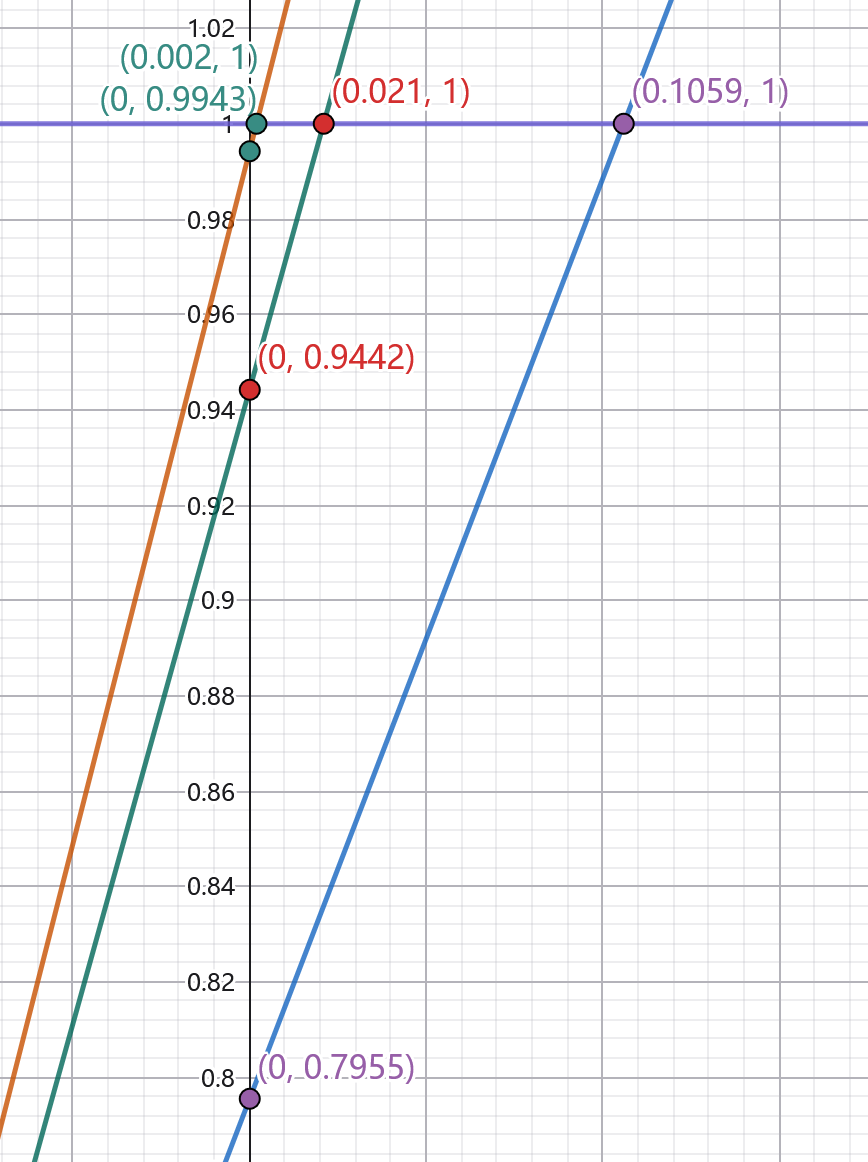
那其实你到这个时候再看就很恐怖了,恰恰相反,恢复原价后 DS 把 GLM 拉爆了。可能你会说 Flash 性能没有 GLM 好啊什么的,你会让 Fable 5 帮你改变量名吗? 我的意思是,什么难度的活就应该让什么模型干,如果你想一个模型从头干到尾这本来就不合理。详见 我的另一篇文章 。
恢复原价后,仅在 r>0.1059 或者 h<79.55% 时原价的 GLM 才能发挥出价格优势。如果你 Vibe Coding 时连 80% 的缓存命中率都不到,讲真的,你该换个 Harness 了。
原价 GLM vs 峰时 DS#
其实上面的结果也并不出乎意料,毕竟哪怕是半价时谷时的 DS 也更具性价比。所以我们来看看对比峰时呢?其实如果你数学好反应快的话,
CostDH=CostGH2×CostDL=2×CostGLCostDL=CostGL你会发现和 半价 GLM vs 谷时 DS 的结果是完全一样的。这意味着,很可惜,还是比不过 DSFlash。
原价 GLM vs DSPro#
但坦率地说,GLM 性能确实比 DSPro 好。都知道 DSPro 是过拟合,目前仍然存在神区二相性,所以 AA 评测仅作参考:
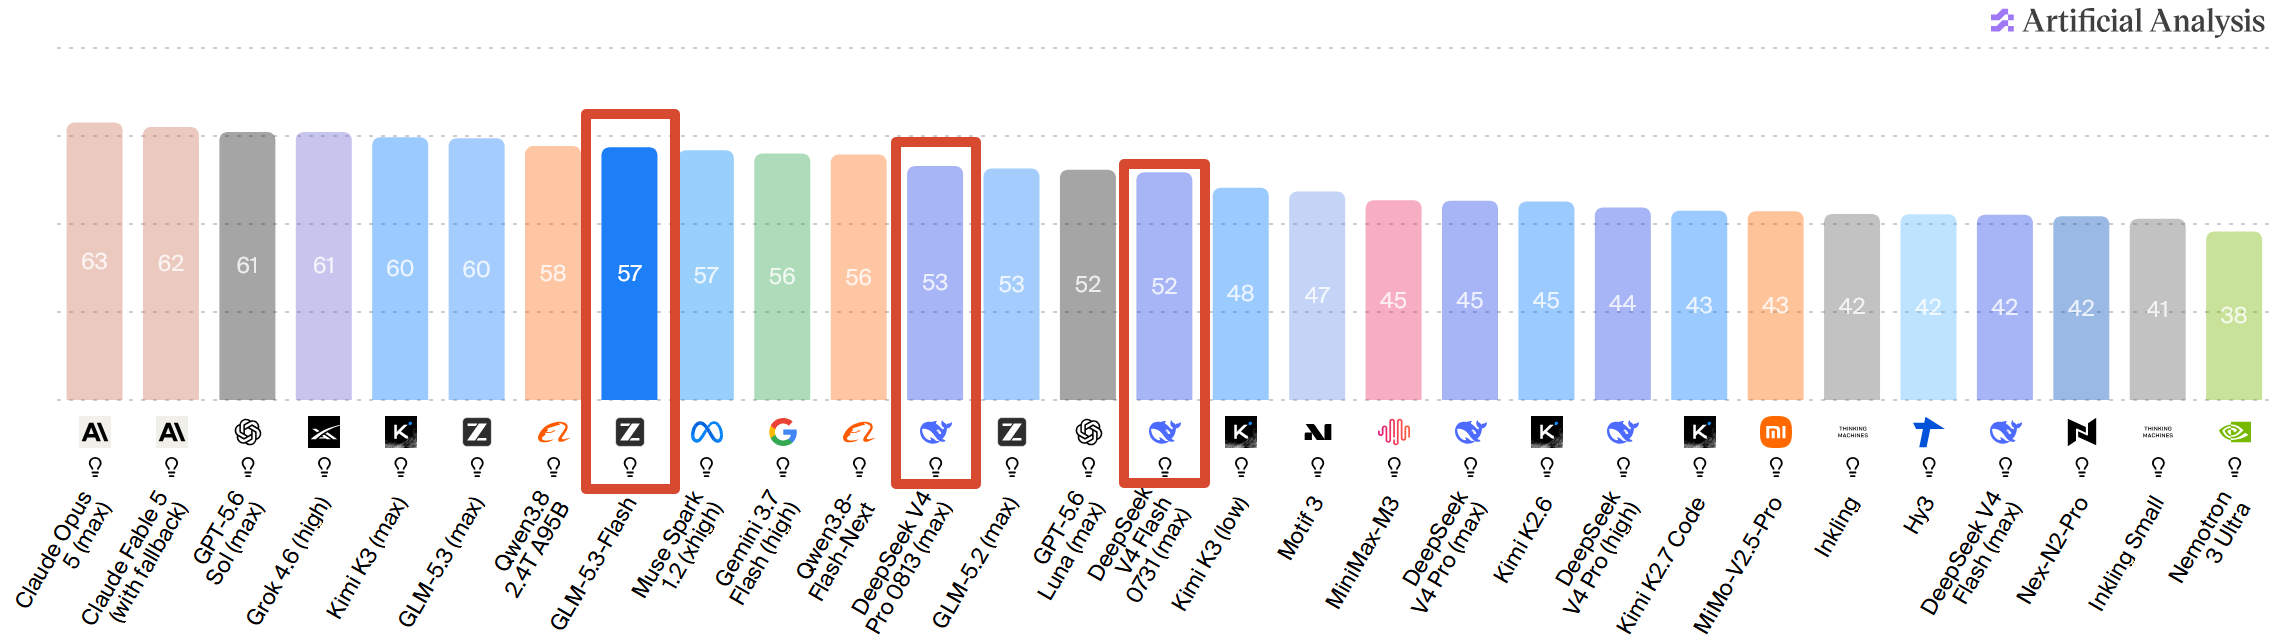
所以其实也许,GLMFlash 更好的去处是平替 DSPro。
代入计算看看:
CostDPL=4.5(1−h)+0.15h+13.5rCostDPL=20270r−87h+90CostDPH=10270r−87h+90hDPL=189535r+185hDPH=8132420r+820线太多了我们去掉一些:
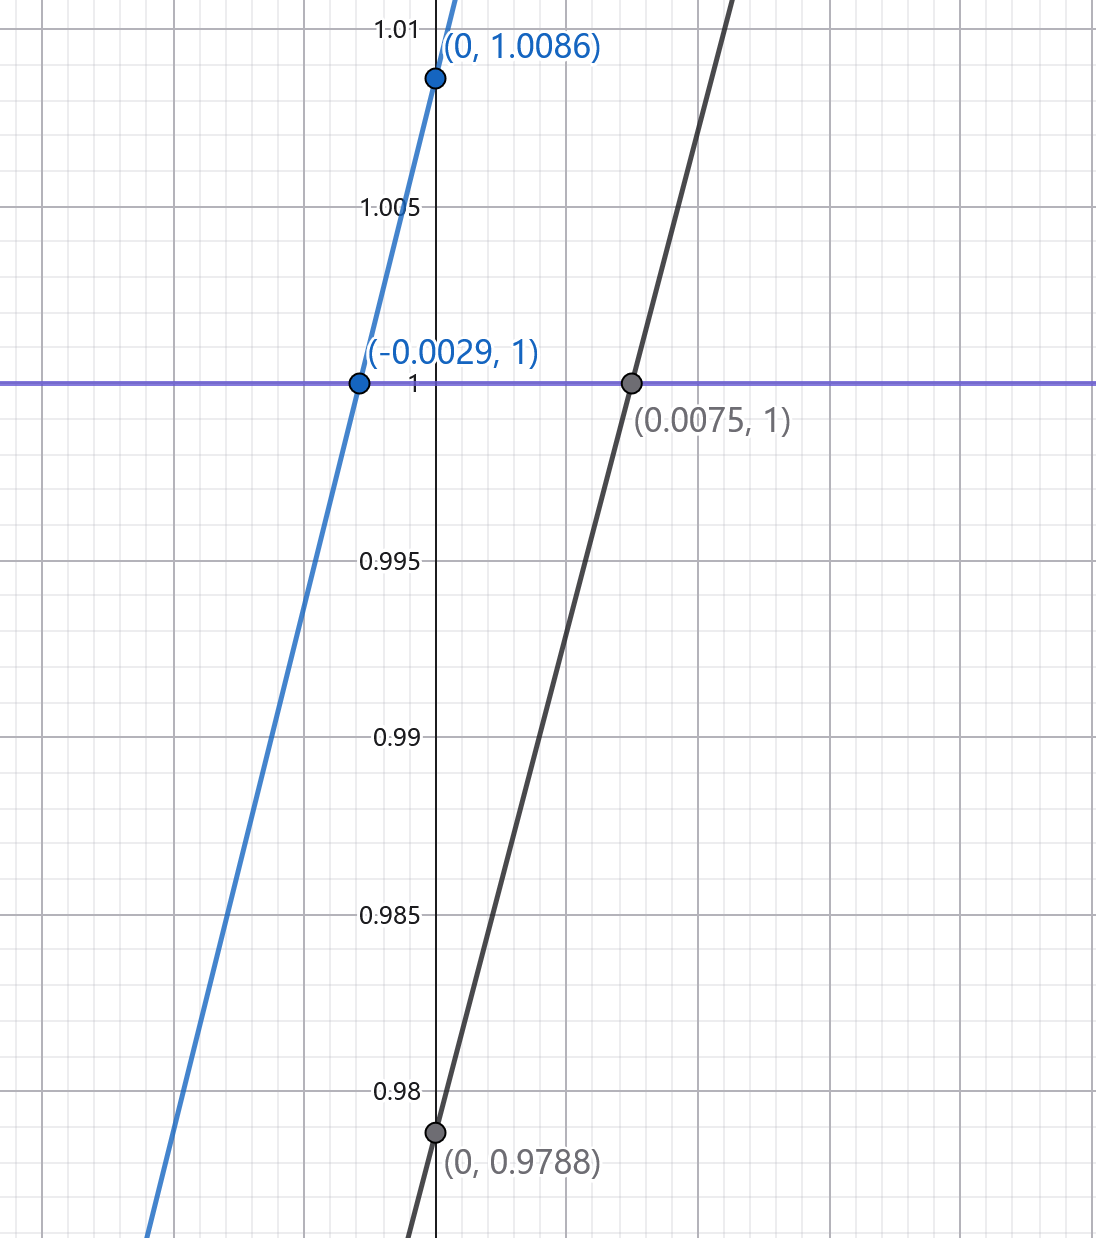
其中蓝线对应峰时 DSPro,黑线对应谷时。可以看到,在谷时的时候,如果 r<0.0075 或者 h>97.88%,仍然是 DSPro 更具性价比。而在峰时,注意到 h>1 且 r<0,超出了定义域,所以总是 GLM 更有性价比。
那 AA 为什么说每任务 GLM 的花费更低?#
很简单,我们刚刚讨论是否有性价比时,讨论的是 h,而默认了令 r=0.003 ,是在这一前提下来对比是否有性价比的。那我们来算一算 AA 榜单的 r 是多少:
由于 AA 没有提供具体的输入 Token 数据,所以需要通过价格反推:
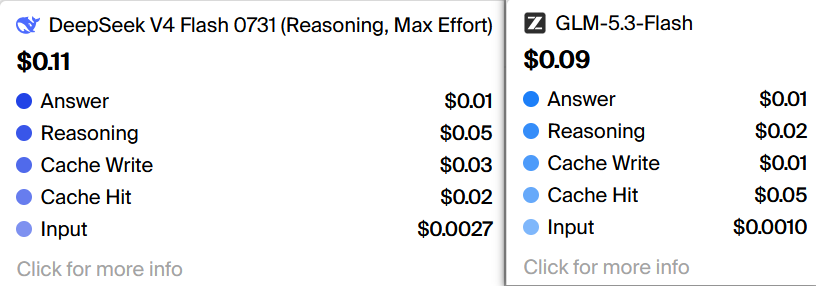 模型每任务价格
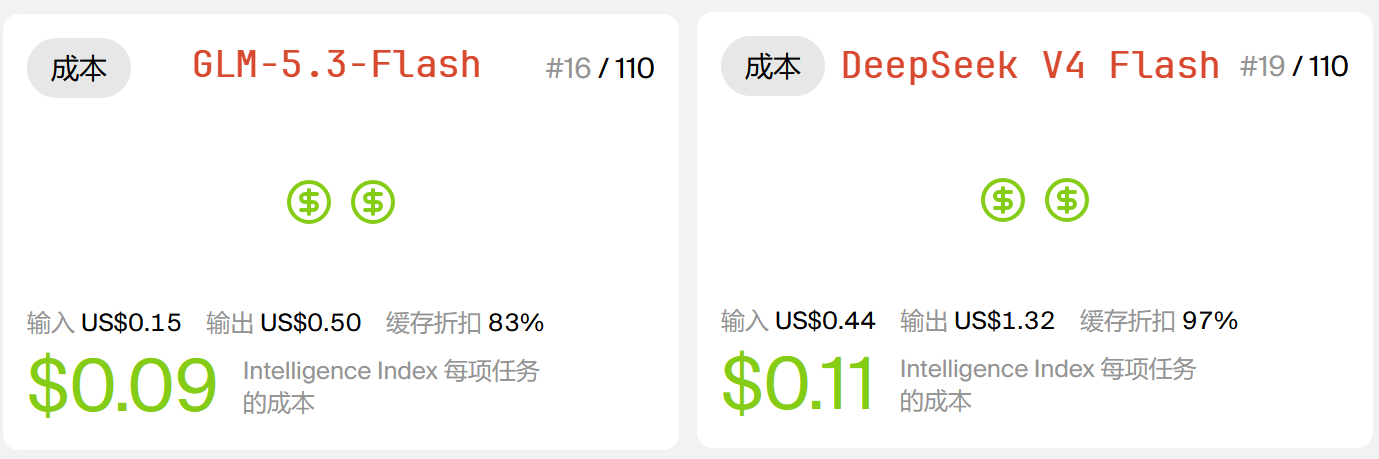 模型成本
计算:
rD=0.440.0027+1.32×(1−0.97)0.020.440.01≈0.045从 AA 的价格上不难看出,大概是 原价 GLM vs 峰时 DS,再回头看坐标系:

在 AA 的测试环境下,DS 不足以完全发挥自己缓存命中的长处,所以无论 AA 怎么测,GLM 看起来就是更便宜,这是从数学的理论上就已经注定的。但实际写代码的时候 r 值可能更低,h 可能更高,所以并不能以 AA 的测评结果武断地说 GLM 比 DS 性价比高。
 KuoHuBlog
